Networking in K8s - inter-pods
整理 Kubernetes 網路模型中 Pod 內 Container 與 Pod 之間(同節點、跨節點)的封包傳輸方式,並提到 VPC CNI。
A Guide to the Kubernetes Networking Model
本文基本上是參考這篇文章,整理重點成我覺得比較好理解的說法,有興趣的讀者們也可以自行參閱原文。
根據官方文件 [ref] ,Kubernetes 的網路模型是基於以下幾點構成的、需要滿足下列幾項條件:
- 所有 pods 之間可以不依靠 NAT (Network Address Translation) 進行溝通
- 所有 nodes 可以向所有 pods 溝通,一樣不透過 NAT
- Pods 自己看到的 IP,要和其他人看到他的 IP 是一樣且獨一無二的
有了以上三點前提之後,會延伸出四條溝通的情境:
- Container ↔ Container
- Pod ↔ Pod
- Pod ↔ Service
- Internet ↔ Service
這篇文章基本上會聚焦在 Pods 之間的網路通訊,也就是前兩種情境,後面兩種會留到下一篇再和 ingress 一起好好介紹。
1. Container ↔ Container Networking (in a Pod)
在 Linux 的世界裡,所有執行中的 process 都能夠透過 root network namespace 來進行溝通。在 network namespace 中提供了自己的 routing / firewall rules / network devices 的組合。也就是說,在同個 network namespace 中的所有 process,可以透過該 network namespace 提供的網路堆疊,作為 process 溝通的管道。
而在探討網路概念時,Pod 會被定義為「一組共享同一個 network namespace 的 containers」。因此,在同個 pod 裡面的 containers 預設會拿到同一組 IP 和 ports,也就是能透過共享的 network namespace 來互相溝通。
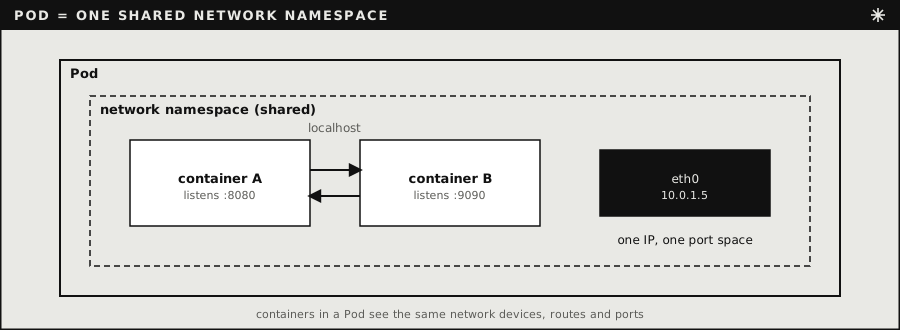
圖:同一個 Pod 內的 containers 共用 network namespace(自行繪製;概念參考原文)
2. Pod ↔ Pod Networking
(打字好累,以下簡稱 network namespace 叫 netns)
#### 先講同個 Node 身上 Pods 之間的傳輸
根據前一段所描述的基本架構,Pod 中的 container 會共享一個 netns,因此 Pod ↔ Pod 溝通「等於是兩個 namespace 之間的溝通」。而在這個情境下,我們可以透過 virtual ethernet devices (veth pair) 的機制,來將 packet 傳到 root netns 來進行溝通。
veth pair 可以想像是由一對 virtual interface 所組成,只要將一個 virtual interface 貼在 root netns、另一個 virtual interface 貼在 pod netns 上,這兩個 netns 就可以透過這一對 veth pair 來進行溝通。
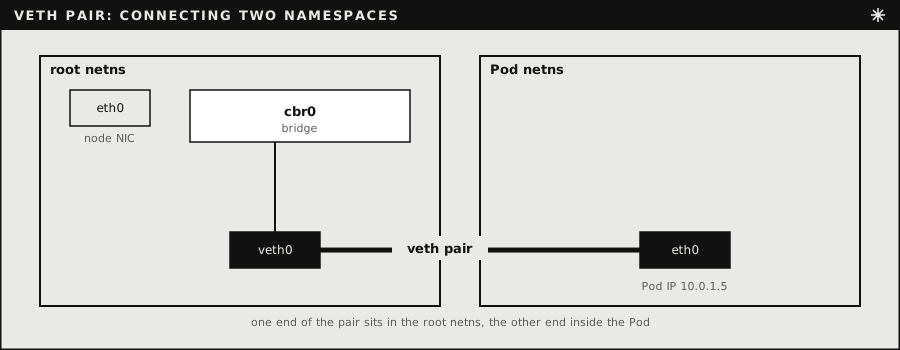
圖:veth pair 連接 root netns 與 Pod netns(自行繪製;概念參考原文)
有了 veth pair 幫我們把封包送到 root netns 之後,我們還需要透過 Bridge 讓封包從 veth0 走到 veth1。這個 Bridge 會看他身上的 ARP table,來根據 IP 決定這個封包要送往哪個 MAC address (assigned by virtual interface)。
基於以上的資訊,我們可以得知,Pod ↔ Pod 在同個節點上的封包傳輸流程會如下圖:
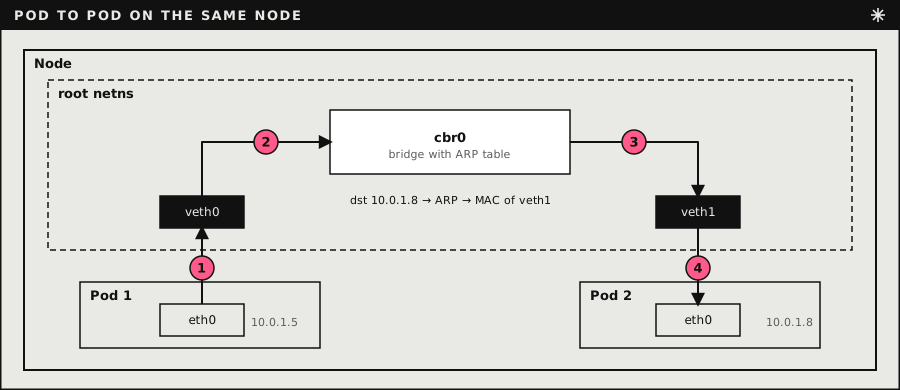
圖:Pod ↔ Pod(同一個節點)的封包流向(自行繪製;概念參考原文)
在第 2-3 步時,cbr0 會根據他自己身上的 ARP table 發現,這個封包上的 IP 對應到的是 veth1 身上的 MAC address,因此封包被正確送到 pod 2 身上。
#### 跨節點的 Pods 之間的傳輸
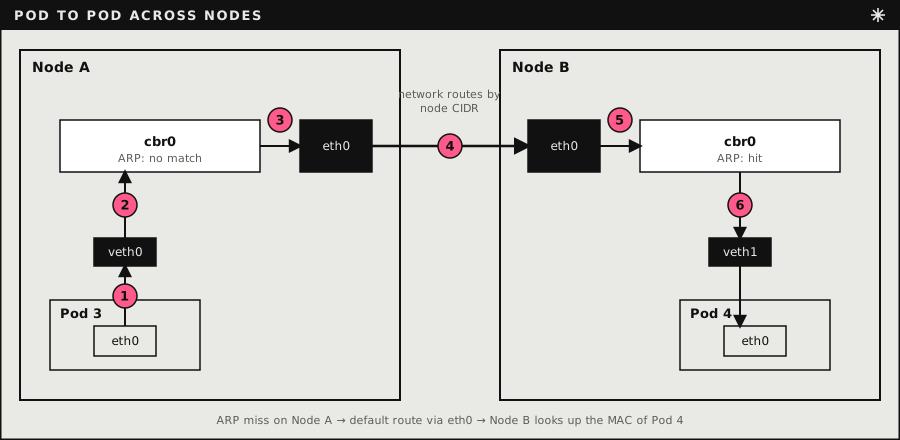
圖:Pod ↔ Pod(跨節點)的封包流向(自行繪製;概念參考原文)
在第 2-3 步時,當 Bridge (cbr0) 發現「娃,root netns 身上沒有對應的 MAC address (ARP failed)」之後,會把封包送去 root netns 的 eth0 (default route)。在第 4 步,假設 network 能做到根據 Node 的 CIDR block,把他送去正確的 Node 中。如此一來,第 5 步時,封包出現在正確的 node 之後,該 node 的 root netns 會再進行一次 ARP 對照,會發現 pod 4 的 MAC address 有對應到 dst IP,接著把這個封包送到 pod 4 當中。
與此同時,CNI (container networking interface) 存在的目的即是完成上述的「Pods 之間傳輸」。舉例來說,AWS 開發的 VPC-CNI,就能做到為每個 pod 開一張 ENI,做為各個 pod 的 eth0;且 VPC 中的 ENI 又都能夠互相連線,達到 pods 之間可以互相傳輸的目的。Pod 在建立時,VPC-CNI 會從該節點的 ENI 所擁有的 IP pool 中挑一個 IP 分配給 Pod 並設定好網路,讓這個 IP 在整個 VPC 內就像一般 EC2 的 IP 一樣可以被原生路由。這樣一來,即便 Pod 被分配在不同節點上,也能透過 VPC 原生的網路基礎設施互相通訊,無需額外設定 overlay。
不過這也代表著,我們在這個 cluster 裡面能開的 pods 數量會被 VPC CIDR 的大小所限制住。為了解決這個問題,我也曾經去研究其他的 CNI、像是 Cilium,這個就等到之後的章節在分享吧~
今天的 K8s 網路基礎上半段就先分享到這。在寫這篇文章時,我去翻了今年年初讀原文的筆記,還再看了一次原文,突然發現讀起來的感覺又不一樣,這次看懂更多東西了(像是 namespace 是啥,我的作業系統都白上了)。希望大家不要跟我一樣浪費補習班或者學校的學費 :D …